CategoriaPagina 1 di 6
LLM Automation: dall'esperimento all'infrastruttura produttiva
Usare un modello linguistico per una demo è facile. Metterlo in una pipeline aziendale che gira ogni giorno, con costi controllati, output verificabile e governance chiara, è un lavoro di ingegneria. Tutta questa categoria ruota attorno a quel passaggio, da giocattolo a strumento.
Molti articoli raccontano il salto dalla demo alla produzione. Un LLM in produzione ha bisogno delle stesse cure di qualsiasi altro componente critico: monitoring di qualità, costi e anomalie, gestione degli errori transitori, budgeting dei token, difesa dagli abusi. Scrivo di come si costruisce una pipeline che regge il carico reale senza far esplodere la bolletta e senza produrre output di cui nessuno si fida.
Altri parlano di automazione applicata al lavoro vero: orchestrazione multi-step, agenti che pianificano ed eseguono, LLM messi in pipeline CI/CD per code review, generazione di test e documentazione, migrazioni assistite. Architetture di automazione che si inseriscono nel processo esistente, senza crearne uno parallelo e incontrollabile.
E c'è il lato scomodo, che raccontano in pochi: il debito di comprensione che l'AI accumula in una codebase mentre sembra accelerare, la sycophancy dei modelli nelle decisioni aziendali, il riposizionamento dell'ingegnere senior, e le decisioni che restano tue e vanno tenute lontane da un modello. Dire con onestà cosa funziona e cosa no serve più di qualsiasi entusiasmo.
Se vuoi portare l'automazione LLM in produzione sul serio, vedi l'automazione con l'AI o scrivimi.
Con l'AI il lavoro dell'ingegnere si sposta dal digitare codice al decidere cosa è giusto. Il mestiere, in fondo, è sempre stato quello.

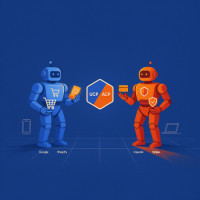 Quando gli assistant AI iniziano a comprare per conto degli utenti, l'e-commerce deve parlare la loro lingua. Universal Commerce Protocol (Google, Shopify) e Agentic Commerce Protocol (OpenAI, Stripe) a confronto: cosa propongono, chi li sostiene, e cosa cambia concretamente per un e-commerce italiano che vuole restare acquistabile da un agente. Stato dei protocolli, coesistenza, e cosa serve preparare adesso senza rincorrere ogni standard emergente. Continua a leggere
 A settembre 2026 un ricercatore lascia Anthropic dichiarando che i prossimi due anni sono crunch time per l'umanità, e pochi giorni dopo il CEO della stessa azienda pubblica un saggio in cui chiede all'industria di rallentare. Fra le due cose c'è un incidente tecnico preciso. Sotto il dibattito escatologico resta però una domanda molto più concreta per chi scrive software, e riguarda cosa succede a una pipeline costruita su un modello di terze parti quando chi lo produce decide di frenare.
 The third part of the local-inference series drops from the 35B MoE to the models most people want on a coding workstation: small, dense, 9-billion-parameter agents. I ran two of them, same base and opposite training recipes, through a full agent loop on a real buggy project plus a Copilot-style autocomplete bench. Neither speed nor correctness separates them: the discriminator is agentic path economy, training- and task-shaped. And local can stand in for Copilot warm, with one 16GB asterisk.
 Bilancio esperienziale dopo settimane di pipeline editoriale e di sviluppo su un modello di frontiera: dove il tier superiore ha fatto davvero la differenza (task lunghi, refactoring estesi) e dove il modello standard bastava a metà del costo. Con il caveat onesto reso evidente dall'affaire Fable 5: un modello di frontiera può essere sospeso dall'alto, il che rafforza il punto sulla sostituibilità. Information gain massimo, niente recensione da rumor.
 Le aziende di frontiera dichiarano che una quota crescente del loro codice è ormai scritta dall'AI, con il task-horizon che si allunga di mese in mese. Lettura ingegneristica e non allarmistica per un decisore: cosa cambia davvero per chi assume sviluppatori junior, dove resta il valore del senior che fa review e architettura, e il rischio della cascata sistemica quando l'AI genera codice che nessuno comprende a fondo. Niente profezie, solo implicazioni concrete sull'organizzazione di un team.
 Quando chiedi a Claude o GPT di analizzare una strategia, una proposta di pricing o un audit interno, il modello tende sistematicamente a darti ragione. Il fenomeno si chiama sycophancy: deriva strutturalmente da RLHF e reward model umano. Il Bullshit Bench 2026 misura che in dominio medico i modelli fanno pushback su premesse errate solo nel 36% dei casi. Confronto fra principali modelli 2026 e mitigation Ask-Don't-Tell che riduce la sycophancy del 40-60% senza fine-tuning.
 Dal febbraio 2026 Anthropic offre prompt caching workspace-level con cache hit al 10% del prezzo input. Eppure nella maggioranza delle integrazioni che vedo in consulenza le cache sono mancate nel 60-80% delle chiamate per errori di design banali. Diagnosi sistematica: cache prefix vs suffix, invalidazione accidentale del system prompt, bloccaggio con tool list dinamica, e pattern che ho misurato portare fino a 90% di risparmio sulla bolletta API.
 Anthropic ha rilasciato in public beta il 1 aprile 2026 Claude Managed Agents - harness fully-managed con container configurabili, SSE streaming, zero DIY su E2B/Modal/Firecracker. Ma ha senso dismettere l'harness self-hosted con gVisor + seccomp + cap-drop che ho descritto nell'articolo sul sandboxing? Diagnosi punto per punto: TCO su scala PMI, superficie di attacco comparativa, vendor lock-in, compliance data sovereignty. Spoiler: la risposta è 'dipende da quattro variabili'.
 GraphRAG classico ha un problema: il costo di indicizzazione è proibitivo (centinaia di dollari per corpus medio). LazyGraphRAG Microsoft rimanda l'estrazione relazionale al query time, riduce 700x il costo per query globale e tiene 0,1% del costo indexing del full GraphRAG, vincendo 96/96 comparazioni a parità di GPT-4o. Tutorial: setup su corpus policy aziendale da 340 documenti, configurazione, benchmark sul mio laboratorio.
 Anthropic Economic Index 2026: analisi su 900+ mestieri O*NET incrociata con dati reali Claude. Per ogni lavoro due cerchi: limite teorico e uso reale. Il 49% dei mestieri ha già almeno un quarto dei task svolti con Claude, ma il gap fra teorico e reale non si chiude per affidabilità, barriere legali, trust. Analizzo i dati di marzo 2026 per sette categorie di mestiere presenti nelle PMI italiane (sviluppatori, contabili, legali, HR, commerciali, project manager, tecnici).