CategoriaPagina 2 di 4
AI Security: mettere in sicurezza il codice e gli agenti che l'AI produce
Insieme alle nuove possibilità, l'AI ha portato nuove superfici di attacco. Codice generato senza revisione, agenti che eseguono azioni con permessi troppo ampi, prompt che diventano vettori di compromissione: sono rischi che vanno affrontati con mentalità da security. Questa categoria unisce le due competenze che il tema richiede.
Molti articoli esplorano le nuove superfici di attacco: la prompt injection che, quando un agente esegue azioni reali, diventa una compromissione di sistema a tutti gli effetti; l'over-broad token scoping con cui un accesso in sola lettura si trasforma in write-and-execute; il threat modeling e il sandboxing degli agenti che eseguono codice arbitrario. Gli stessi principi del least privilege, applicati a un attore nuovo.
Altri si occupano del codice AI-generated da mettere in sicurezza: entra in produzione in fretta e replica pattern insicuri visti in addestramento, con classi di vulnerabilità prevedibili. Auditarlo in modo sistematico, dal lato difensivo e da quello offensivo, è ormai una competenza necessaria.
Poi la governance e la continuità: come si governano gli agenti in azienda, cosa implicano i classifier e i freni dei modelli per chi fa security, e il rischio di continuità quando un modello può essere spento per decisione normativa. Fare sicurezza vuol dire anche evitare di restare a terra.
Se stai introducendo agenti AI e vuoi farlo in sicurezza, vedi la sicurezza AI per le aziende o scrivimi.
Un agente AI con troppi permessi diventa una vulnerabilità che parla in linguaggio naturale.
 Mettere un agente di coding in produzione significa dargli accesso a shell, file e credenziali. Il setup di sicurezza che uso davvero parte da un validatore dei comandi bash, un perimetro operativo definito via rules, il deny esplicito delle operazioni distruttive (rm -rf), gli env file in sola lettura e il blocco degli host non gestiti. Insider puro: trasformo il mio scaffolding personale in un case study difensivo replicabile, alla luce delle CVE su Claude Code del 2026. Continua a leggere
 Nei log di un sito reale compaiono richieste a path sensibili come .env, .ssh/id_rsa e .aws/credentials veicolate dagli user-agent di assistant AI come ChatGPT e Perplexity. Sono pochi tentativi isolati, non una campagna: ma il pattern è interessante per chi espone un'applicazione. Analisi forense onesta di cosa si vede davvero nei log, con la metodologia per distinguere il rumore dal segnale e le contromisure lato server. Information gain di prima mano, background offensivo dell'autore.
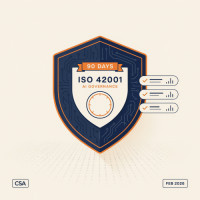 Il 72% dei buyer enterprise chiede ISO 42001 nelle RFP 2026 (CSA, febbraio 2026). Se sei una PMI italiana di consulenza o software e vuoi vincere gare con grandi clienti europei, ISO 42001 non è più optional nel secondo semestre. Ma 4-12 mesi di implementazione full sono troppi - ti mostro come passare il gate in 90 giorni sfruttando l'overlap 60% con ISO 27001, mappando i 38 controlli a SoA esistente e producendo evidence equivalente su 14 controlli residui.
 Running a serious LLM on your own hardware is no longer a lab exercise. I put a 16GB consumer GPU through a 35-billion-parameter Mixture-of-Experts model with 262,000 tokens of context, and the agentic tool-calling came out 100% reliable. This is the strategic half of the story: why local inference turned from a hobby into architectural insurance in 2026, after a frontier model was suspended worldwide by government order. The hard numbers live in the companion deep-dive.
 Il caso Fable non è un'eccezione ma una direzione: l'Executive Order USA del 2 giugno 2026 introduce un accesso governativo anticipato ai frontier model, e l'industria stessa propone un regime in stile FAA con il potere statale di bloccare o revocare un modello. Per un CIO o un decisore europeo significa una cosa precisa: un asset critico può essere governato da regole di un paese terzo. Come tradurlo in voci concrete del risk register, etichettando le proposte come posizioni, non come norme.
 Fino a dicembre 2025 vendere un'integrazione MCP come consulente italiano richiedeva spiegare 'è una tecnologia Anthropic, ma è open'. Dal 9 dicembre 2025 Anthropic ha donato MCP alla Agentic AI Foundation sotto Linux Foundation, e al 24 febbraio 2026 AAIF conta 146 membri platinum tra cui AWS, Google, Microsoft, OpenAI. Ti racconto l'impatto operativo su una RFP italiana fittizia, con template di clausola contrattuale vendor-neutral già passato dal legale.
 Il 9 giugno 2026 Anthropic lancia Fable 5, il modello più capace mai reso pubblico; il 12 giugno il governo USA ne impone la sospensione globale con una direttiva di export control. Per un decisore che ha messo l'AI in produzione non è una notizia di settore: è la dimostrazione che dipendere da un singolo frontier model non è solo rischio commerciale o tecnico, ma di continuità imposta dall'alto: disponibilità, confidenzialità e portabilità in un colpo solo.
 AA Omniscience di Artificial Analysis (novembre 2025) misura su 6.000 domande in 6 domini un fenomeno che le big AI preferiscono ignorare: quando il modello non sa, inventa o dice non lo so? Solo 3 modelli su 36 ottengono punteggio sopra zero (Claude Opus 4.1, GPT-5.1, Grok 4). Anthropic occupa le prime 3 posizioni per hallucination rate più basso. Tabella comparativa 2026 e implicazioni pratiche per chi sta scegliendo un modello per la pipeline aziendale.
 Il 26 marzo 2026 il Parlamento Europeo ha votato il rinvio dell'AI Act Annex III al 2 dicembre 2027, ma il trilogue non è concluso e gli standard CEN-CENELEC non sono pronti. La posizione prudente per una PMI italiana è pianificare come se la deadline del 2 agosto 2026 fosse ancora binding. Otto azioni concrete da eseguire in 90 giorni, dalla mappatura dei sistemi AI al balancing test documentato, con checklist sanitaria e tempo di esecuzione stimato per ogni passo.
 Nel 2023 Sam Altman prometteva di risolvere le allucinazioni in due anni; nel 2025 OpenAI stessa pubblica "Why Language Models Hallucinate" (arxiv 2509.04664) mostrando che sono strutturalmente inevitabili. AA-Omniscience 2025 di Artificial Analysis: 36 modelli su 40 più propensi a sbagliare che sapere. GPT-5.5 xhigh: 86% hallucination rate vs Opus 4.7 max 36%. Perché il prompting non le elimina, pattern di validazione esterna che funzionano in produzione.